
主题
失败诊断
作业失败以后,最费时间的往往不是改,而是找原因:翻几千行日志、对表结构、查资源、查权限。平台在失败实例上提供「智能诊断」:它自己决定去取哪些证据,日志、运行信息、表结构、资源用量、授权记录都会查,最后给出归类、根因和可以直接照做的修法。
演示环境里放了 6 个典型的失败,覆盖数据开发里最常见的几类问题。每一个都是真实运行失败、真实诊断出来的。
| 作业 | 出了什么事 | 诊断归类 | 诊断给的修法(摘要) |
|---|---|---|---|
dws_refund_ratio_1d | SQL 里引用了源表没有的列 | SQL | 列出源表实际的列,指出 refund_amount 不存在;改成已有字段,或先在上游补出退款列 |
dwd_payment_detail_di | 上游金额里混进了「元」字 | SQL | 先清洗再转数值,或用容错转换并标记脏行;长期在 ODS 层落纯数字 |
dim_user_merge_1d | MERGE 的源表同一用户有多行 | SQL | 按用户去重(给出完整的 ROW_NUMBER 写法),或先按最新日期过滤 |
user_feature_export | Python 作业内存超限被杀 | 资源(OOM) | 内存从 512MB 提到 1~2GB;把一次性加载改成分块处理 |
push_daily_report | Shell 用了 macOS 的日期写法 | 脚本 | 改成 Linux 的 date -d "yesterday",或换成跨平台写法 |
dws_category_brand_1d | 读别的空间的表,授权被撤销 | 权限 | 向表的属主空间重新申请读授权,获批后重跑 |
1. 不只看报错那一行
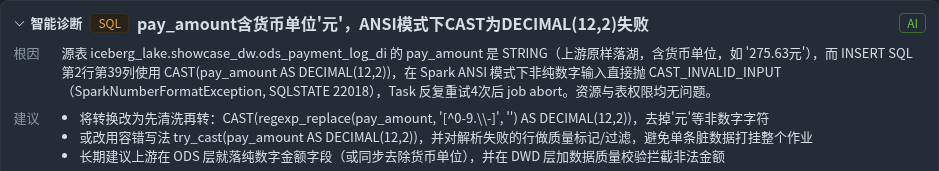
脏数据这个例子里,报错本身只说「转换失败」。诊断顺着去看了源表的结构,发现金额列是字符串,且样例里带着「元」,这才把原因落到上游数据:
2. 进程被直接杀掉,也能定位
内存超限的进程是被系统强制终止的,来不及留下任何报错——日志停在「已读入第 20 天」,后面就没有下文了:
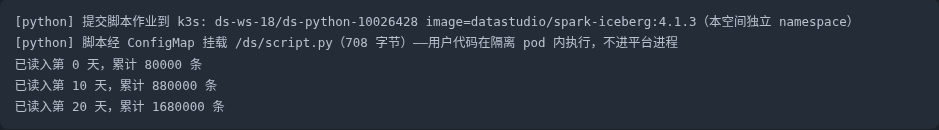
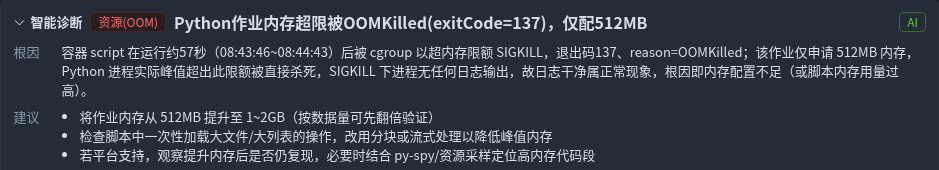
只看日志是找不到原因的。诊断从运行信息里拿到了退出码 137 和「OOMKilled」,对照作业只申请了 512MB 内存,给出结论,并说明没有报错日志正是这类失败的特征:
3. 权限问题会查授权记录
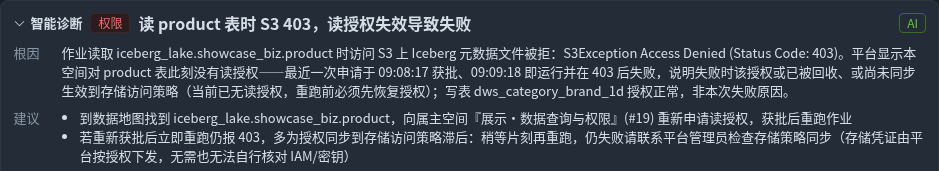
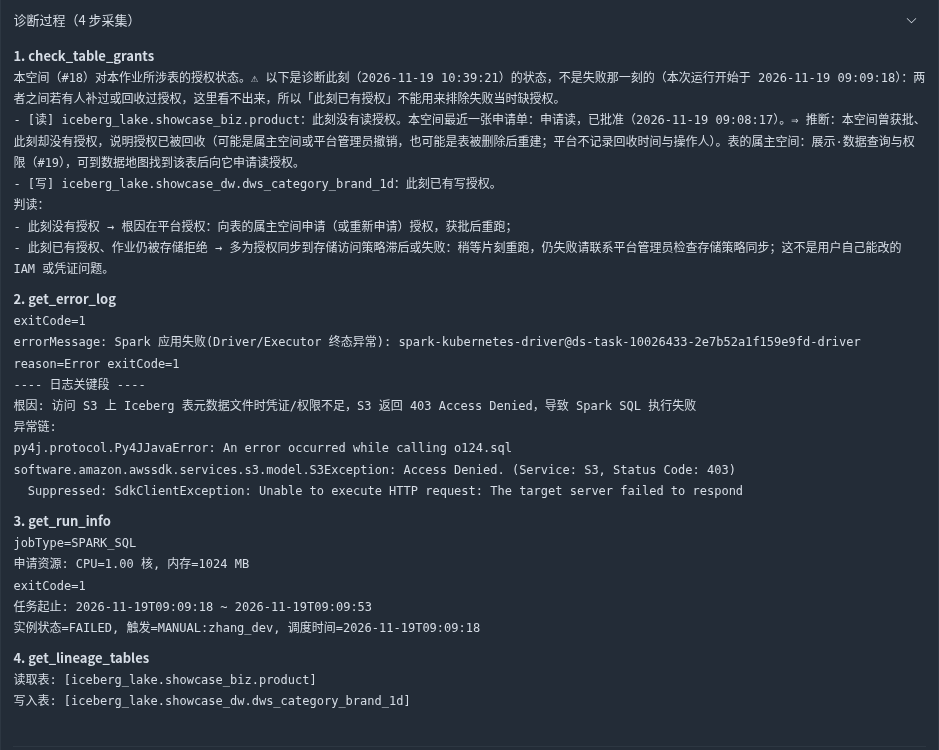
作业读了别的空间的表,授权被撤销以后,下一次运行在存储层被拒(403)。光看报错,很容易以为是存储的访问策略配错了。诊断会去查这个空间对那张表现在有没有授权、最近一次申请是什么时候批的,于是给出的修法是走平台上的申请流程,而不是去改存储配置:
这条授权是怎么批下来、又怎么被撤销的,见 权限与安全 · 跨空间共享。
4. 诊断过程可以展开
每份诊断都可以展开「诊断过程」,看它依次取了哪些证据、每一步拿到了什么。结论不是凭空给的,每一条都能对到证据上。以撤权那次为例:
自己去看
切到 「展示·数据开发与调度」,进 运维监控 → 作业运维,搜上表里的作业名,点开失败的那次运行,诊断就在实例详情里。
下一篇:实时集成 →