
主题
实时集成
不是所有数据都适合等到第二天凌晨。订单状态一变,下游就想知道;用户的点击,几秒内就该能查到。演示环境里有两条实时链路,都是 Flink 流作业,把数据持续写进数据湖:
| 作业 | 类型 | 做什么 |
|---|---|---|
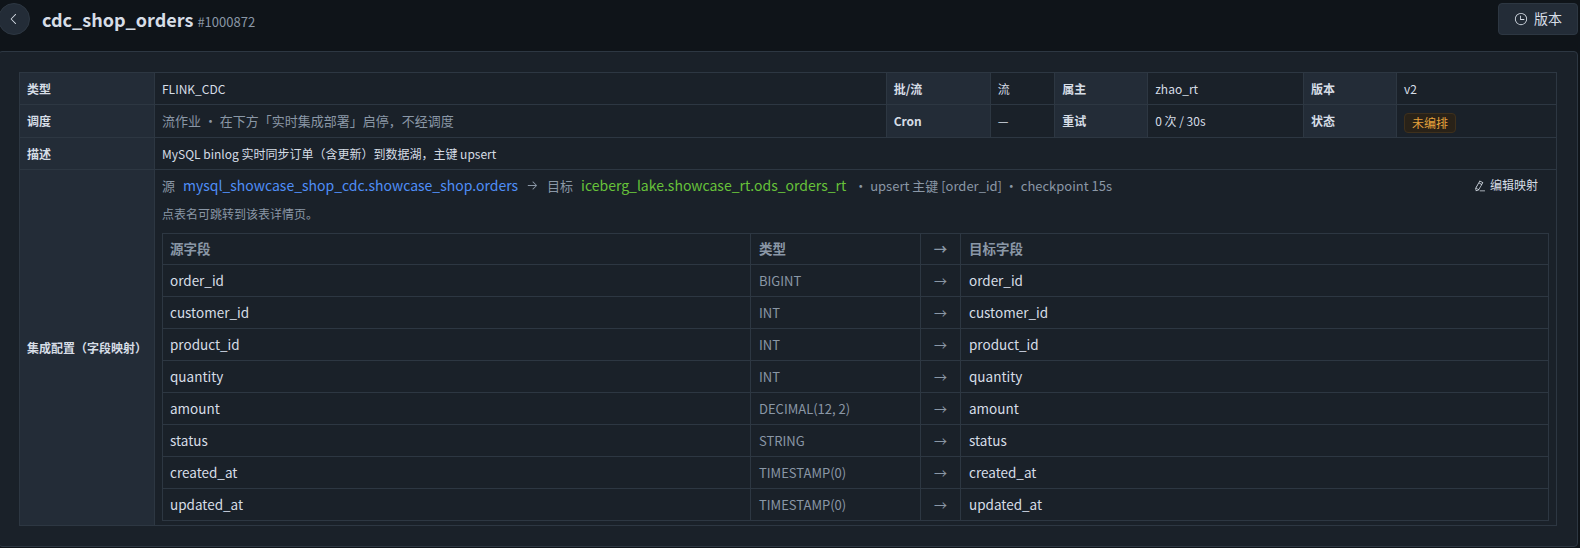
cdc_shop_orders | Flink CDC | 订阅商城业务库(MySQL)的变更日志,订单的新增和修改实时同步进湖,按主键更新 |
stream_click_events | Flink SQL | 每秒 20 条埋点事件,按天分区写入湖表 |
两条都真跑过一段,然后停下,停止时留了 savepoint。
1. 业务库变更实时进湖
CDC 作业不用写代码:选源表、选目标,字段映射自动带出来,按主键 upsert:
流作业不进工作流、不按 cron 调度,在作业详情下方的「实时集成部署」里直接启停:
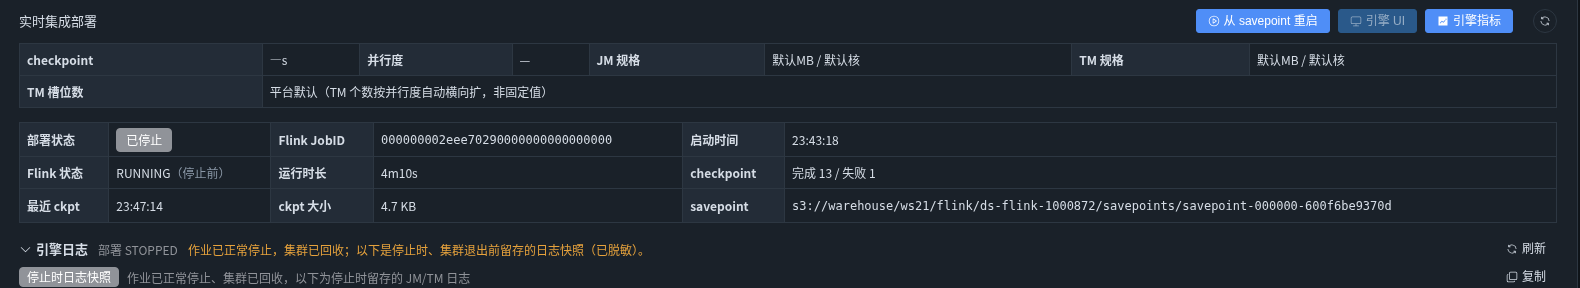
- 停止会先做 savepoint,下次从这个点接着读变更日志,不丢、不重;
- 停下以后也看得到:停止前的运行时长、checkpoint 统计都留着,「引擎日志」是停止那一刻留下的 JobManager / TaskManager 日志快照。
2. 改单在湖里是「改」,不是「多一行」
作业运行期间,源库里每轮新增 300 单,其中 80 单随后改成「已发货」。从湖里读回来:
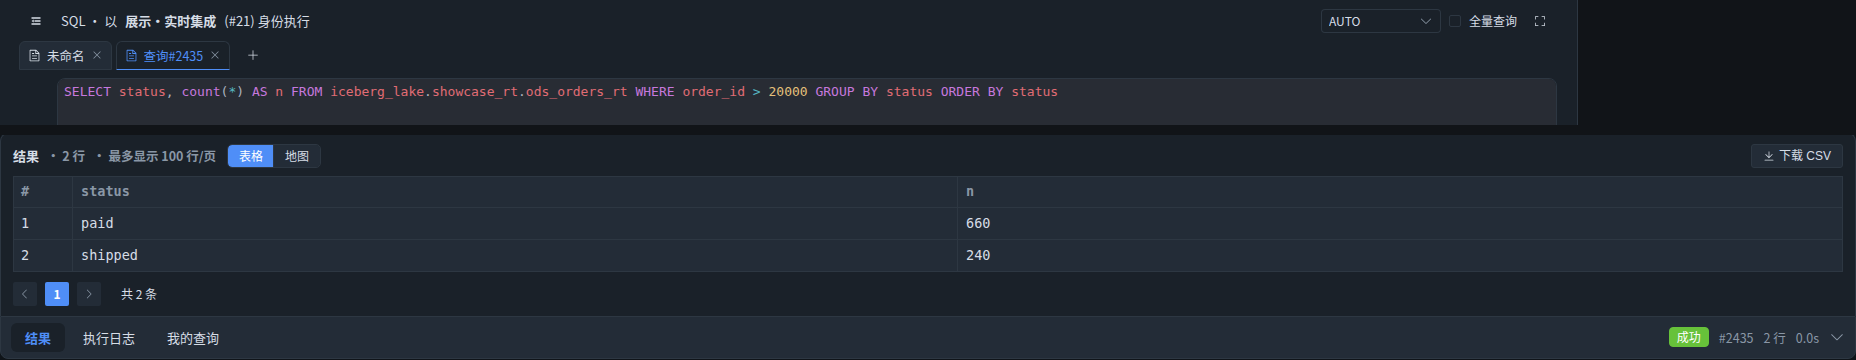
三轮一共新增 900 单,其中 240 单被改成已发货。湖里正好是 900 行:660 单已支付、240 单已发货。改单按主键落到了原来那一行上,而不是追加一条新记录——下游直接查这张表,看到的就是每张订单的最新状态。
3. 写 SQL 的流作业
不是业务库同步,而是要自己写处理逻辑的,用 Flink SQL 流作业。埋点这条用 Flink 自带的数据生成器模拟事件源,每秒 20 条,按事件时间算出日期,按天分区写入湖表:
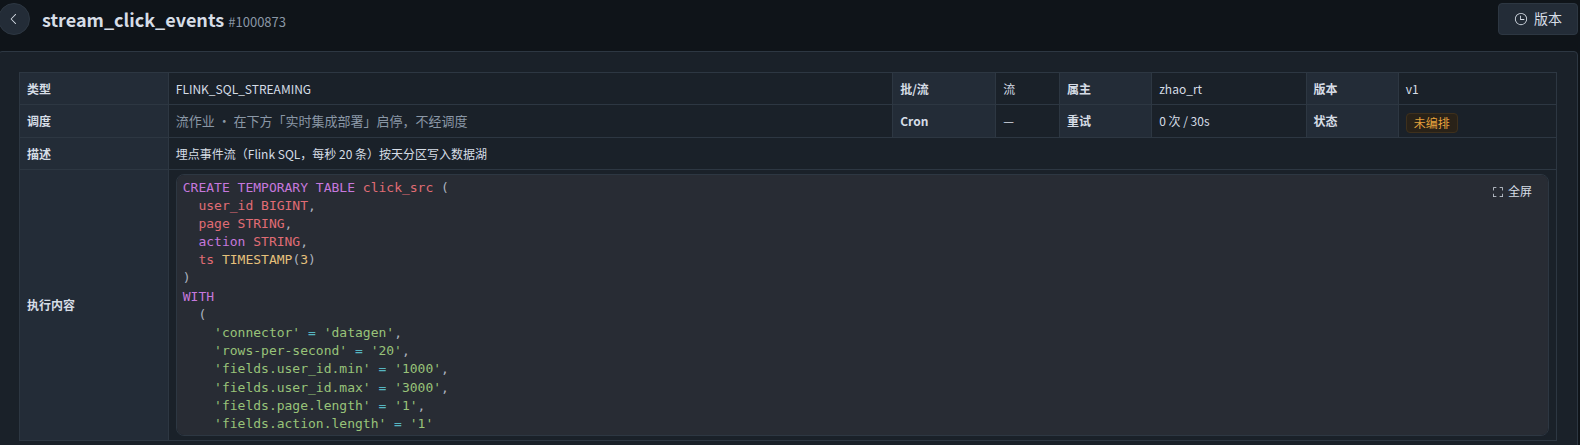
每个流作业都是独立的 Flink 集群,用所在空间的受限身份运行:它只能写自己空间的表。资源从空间配额里扣,额度不够时,启动直接被拒,不会排着队挤占别人。
自己去看
切到 「展示·实时集成」:
- 数据开发 →
cdc_shop_orders:字段映射、部署状态、checkpoint、savepoint、停止时的引擎日志 - 数据开发 →
stream_click_events:Flink SQL 与部署记录 - 查询链接:查询 #2435 从湖里读回 CDC 同步的订单(要先切到「展示·实时集成」空间再打开)