
主题
引擎与选路
写 SQL 的人不该先想「这条该用哪个引擎」。平台的查询编辑器背后接了三种引擎,各有所长:
| 引擎 | 擅长 |
|---|---|
| Spark | 什么都能跑:读写数据湖、建表、大数据量计算;每个空间有自己常驻的 Spark 查询引擎 |
| Trino | 只读查询秒级返回;能把业务库和数据湖放进同一条 SQL 里关联 |
| Doris | 查 Doris 里的分析表 |
编辑器右上角默认选 AUTO:平台看这条 SQL 做什么、读了哪些表,替你选引擎。
1. AUTO 怎么选
| 这条 SQL | 交给 | 为什么 |
|---|---|---|
| 写表、建表、改表 | Spark | 只有 Spark 能写 |
| 只读,只查 Doris 的表 | Doris | 自己的表自己查最快 |
| 只读,读的是数据湖 / 业务库 | Trino | 秒级返回 |
| 其余情况 | Spark | 兜底,什么都能跑 |
只读查询:交给 Trino,1 秒出结果
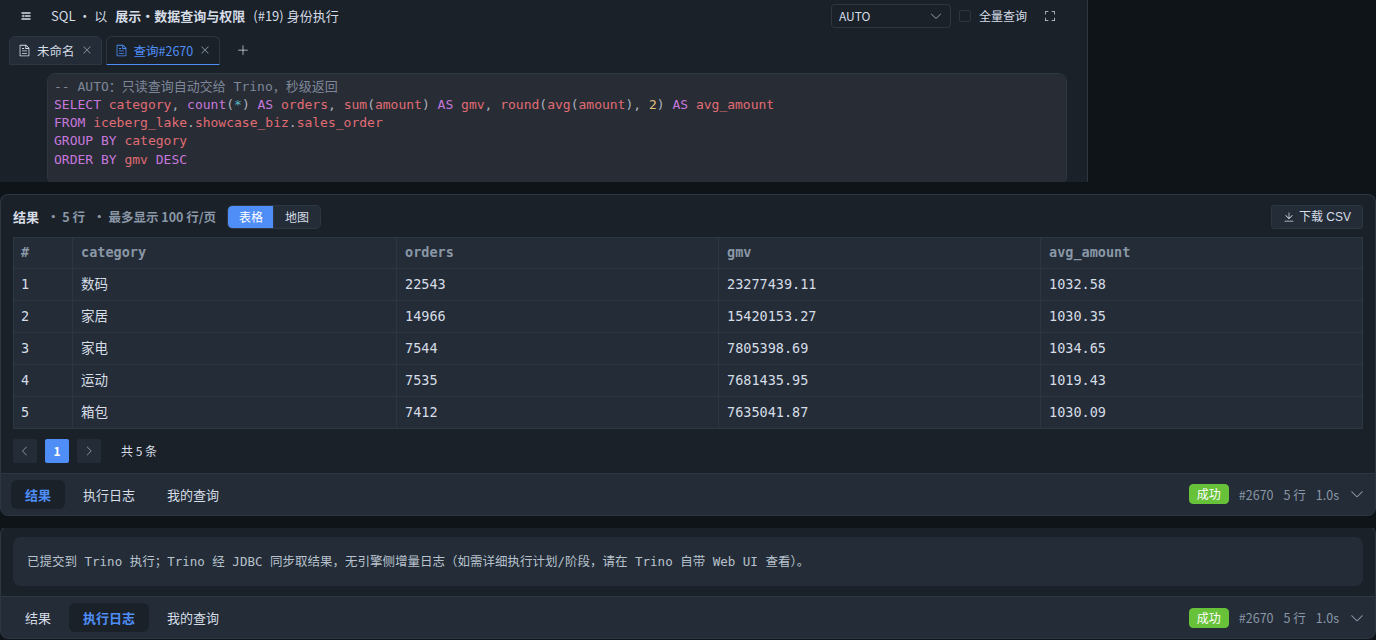
按品类汇总 6 万条订单,AUTO 交给了 Trino,1 秒返回。「执行日志」里写明了是 Trino 执行的:
业务库 × 数据湖:一条 SQL 关联
客服工单在客服系统的 MySQL 里,订单在数据湖里。想知道「哪个品类、哪类工单最多、多久解决」,不用先把工单同步进湖,直接写一条 SQL 关联两边:
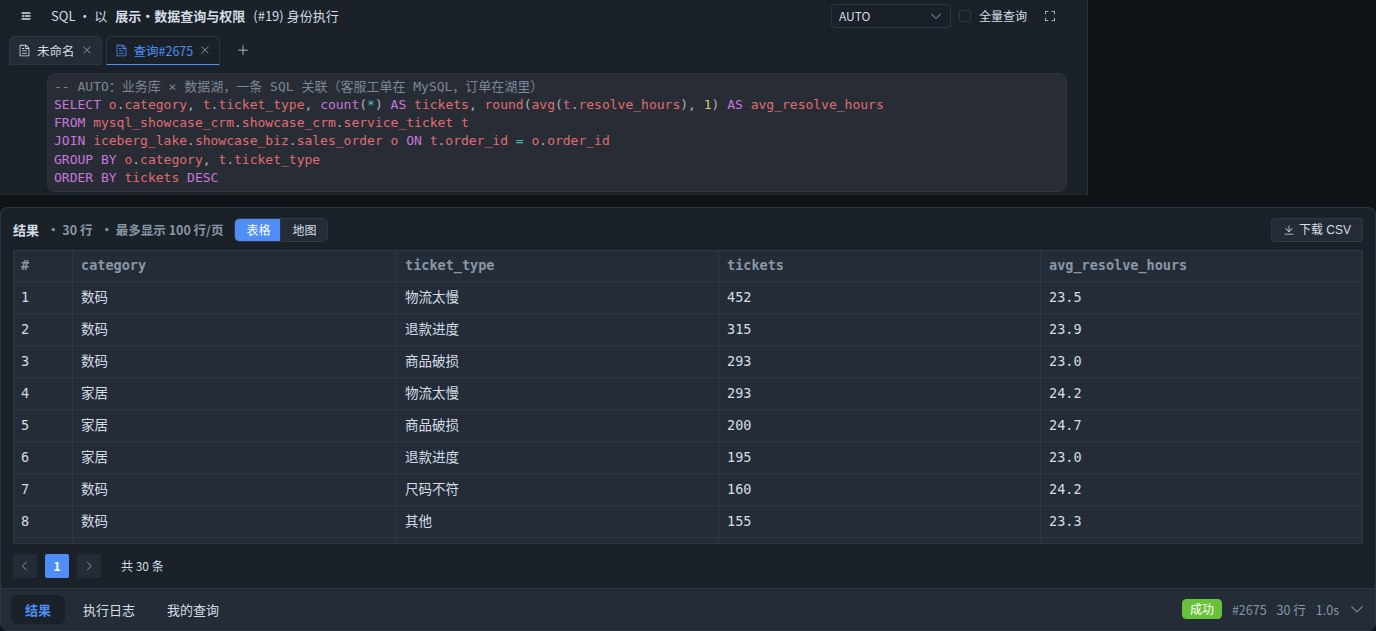
业务库要先在平台上登记为数据源,才能这样查。登记时填的是只读账号,库的连接信息不会出现在 SQL 里,每次查询也照样要过表级权限检查。
Trino 不认的写法:自动交给 Spark
percentile_approx 是 Spark 的函数,Trino 里没有。AUTO 在提交前先让 Trino 校验一遍,发现不认识,就直接交给 Spark,不用你改写:
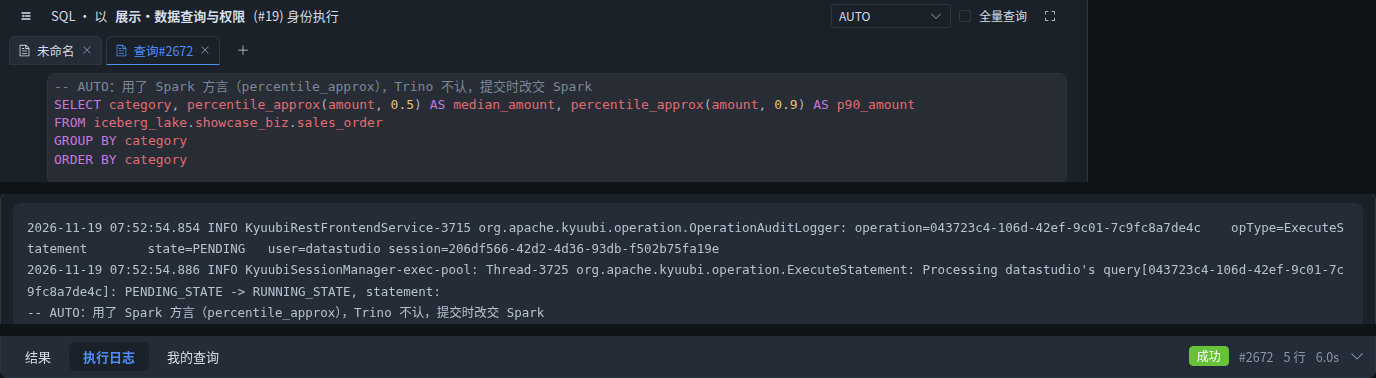
同样,建表并写入品类日汇总这条 AUTO 直接交给了 Spark。
另一种情况是 Trino 跑到一半失败:资源不够、超时这类问题,会在同一条查询里自动改用 Spark 重跑,日志里留一行说明。列名写错、没有权限这类问题不会重跑,换引擎也一样会失败,直接报错更快。
2. 自己选引擎时:提交前先校验
也可以手动指定引擎,平台照办,不会偷偷换。手动选 Trino 或 Doris 时只能跑只读查询,写表一律走 Spark。
手动选 Trino 时,SQL 会先拿给 Trino 校验一遍。列名拼错了,提交前就会弹出提示,不用等到跑完才知道:
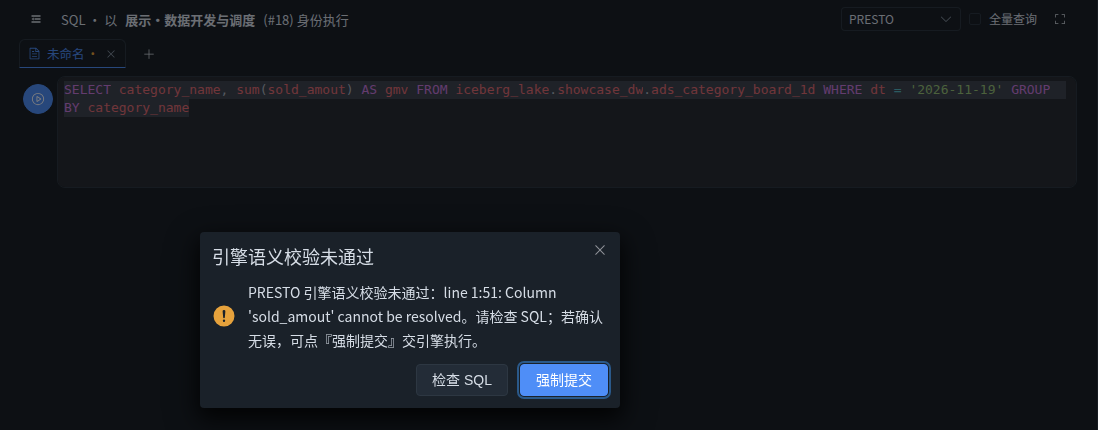
确认 SQL 没问题(比如用了校验识别不了的写法),可以点「强制提交」,交给引擎去裁决。
3. 每个空间一份 Spark 查询引擎
Spark 查询引擎是按空间独占的:同一个空间的人共用自己那份,不和别的空间混跑。
- 引擎的规格从空间的资源配额里出,由空间管理员申请、平台管理员审批;
- 一个空间可以建多份,比如给重查询单开一份大规格的;
- 引擎以本空间的身份读写数据,只能碰本空间有权限的表。
编辑器顶部写的「以 展示·数据查询与权限(#19)身份执行」就是这个意思。哪些表能查、哪些列能看,见权限与安全。
自己去看
切到 「展示·数据查询与权限」 空间再打开下面的链接:
- 只读查询走 Trino(#2670)
- 业务库 × 数据湖关联(#2675)
- Spark 写法自动交给 Spark(#2672)
- 建表写数走 Spark(#2673)
- 每条都点开下方「执行日志」,看是哪个引擎执行的